Yapay zekâ bir fotoğrafı nasıl görür?
Bir arkadaşının fotoğrafına baktığında onu bir saniyede tanırsın. Gözlerini, gülüşünü, saçını. Bir bilgisayar ise aynı fotoğrafa baktığında bunların hiçbirini görmez. Onun elinde yalnızca sayılar vardır.
Bu sayfada, bir fotoğrafın makinenin gözünde neye dönüştüğünü ve makinenin o sayılardan bir yüzü nasıl tanıdığını adım adım göreceğiz. Hiçbir ön bilgi gerekmiyor.
1. Fotoğraf aslında küçük karelerden oluşur
Telefonundaki bir fotoğrafa iyice yakınlaşırsan, bir noktadan sonra görüntü küçük renkli karelere bölünür. Bu karelerin her birine piksel denir. Bir telefon fotoğrafında genellikle on milyonlarca piksel vardır; o kadar küçüktürler ki gözün onları tek tek ayırt edemez.
2. Her kare bir sayıdır
Siyah beyaz bir fotoğrafta her piksel tek bir sayıyla anlatılır: ne kadar parlak olduğu. 0 tam siyah, 255 tam beyaz, aradaki sayılar griler.
Aşağıdaki çivi panosu 12 × 12 = 144 piksellik minicik bir resim. Her çivi bir piksel. Çivi ne kadar uzunsa ve tepesi ne kadar açıksa, o piksel o kadar parlak. Bir çivinin üstüne gel: yandaki kadran o pikselin sayısını okur, alttaki tabloda aynı sayı yanar.
| 18 | 18 | 18 | 18 | 18 | 18 | 18 | 18 | 18 | 18 | 18 | 18 |
| 18 | 18 | 18 | 18 | 112 | 112 | 112 | 112 | 18 | 18 | 18 | 18 |
| 18 | 18 | 112 | 214 | 214 | 214 | 214 | 214 | 214 | 112 | 18 | 18 |
| 18 | 112 | 214 | 214 | 214 | 214 | 214 | 214 | 214 | 214 | 112 | 18 |
| 18 | 214 | 214 | 34 | 34 | 214 | 214 | 34 | 34 | 214 | 214 | 18 |
| 112 | 214 | 214 | 34 | 34 | 214 | 214 | 34 | 34 | 214 | 214 | 112 |
| 112 | 214 | 214 | 214 | 214 | 214 | 214 | 214 | 214 | 214 | 214 | 112 |
| 18 | 214 | 58 | 214 | 214 | 214 | 214 | 214 | 214 | 58 | 214 | 18 |
| 18 | 112 | 214 | 58 | 58 | 58 | 58 | 58 | 58 | 214 | 112 | 18 |
| 18 | 18 | 112 | 214 | 214 | 214 | 214 | 214 | 214 | 112 | 18 | 18 |
| 18 | 18 | 18 | 18 | 112 | 112 | 112 | 112 | 18 | 18 | 18 | 18 |
| 18 | 18 | 18 | 18 | 18 | 18 | 18 | 18 | 18 | 18 | 18 | 18 |
Yukarıdan bakınca sen gülen bir yüz görüyorsun. Makine ise yalnızca alttaki tabloyu görüyor. Yapay görmenin bütün işi bu iki görüntü arasındaki yolu kat etmek, yani sayılardan anlama ulaşmak.
Renkli fotoğraflarda her piksel için üç sayı vardır: ne kadar kırmızı, ne kadar yeşil, ne kadar mavi. Ekranındaki her renk bu üç sayının karışımıdır.
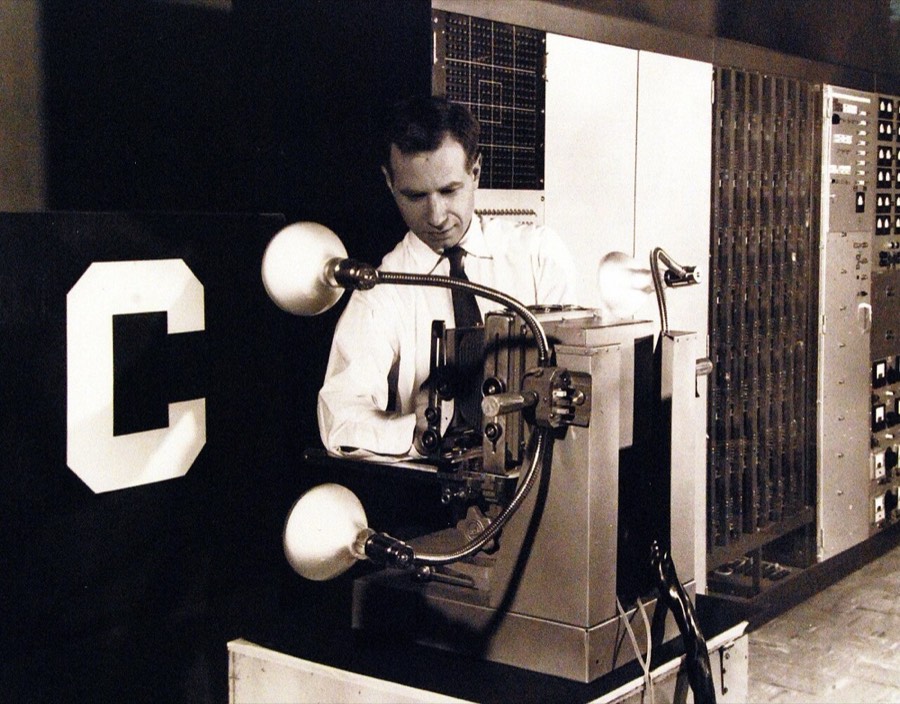
Bu fikir yeni değil. 1958’de yapılan Mark I Perceptron’un gözü, 20 × 20 düzende dizilmiş 400 ışık algılayıcısıydı. Yani dünyayı 400 piksellik bir resim olarak görüyordu ve bu resimlerden harfleri tanımayı öğrendi.
3. Önce küçük şeyleri arar: kenarlar
Bir çocuğa yüz çizmeyi öğretirken önce çizgilerden başlarsın. Makine de öyle yapar. Önce resmin üzerinde küçük bir pencere gezdirir ve her yerde aynı basit soruyu sorar: “Burada açıktan koyuya bir geçiş var mı?” Böylece kenarları bulur.
Bu pencereye filtre denir. Atlas’taki evrişimli ağ levhasında bir filtrenin resmin üzerinde nasıl kaydığını ve her konumda bir sayı hesapladığını canlı izleyebilirsin.
4. Kenarlardan şekillere, şekillerden nesnelere
Kenarlar bulunduktan sonra bir sonraki katman onları birleştirir: iki eğri çizgi bir göz olabilir, üçgen iki şekil bir kedinin kulakları. Bir sonraki katman bu parçaları birleştirir: iki göz, bir burun ve iki kulak yan yana ise bu bir kedi yüzü olabilir.
Her katman bir öncekinin bulduklarını biraz daha anlamlı bir şeye dönüştürür. Modern görüntü modellerinde onlarca, bazen yüzlerce böyle katman vardır.
5. Peki bunu kim öğretti?
Kimse makineye “kedi kulağı üçgendir” diye bir kural yazmadı. Bunun yerine ona etiketlenmiş milyonlarca fotoğraf gösterildi: “bu kedi”, “bu köpek”, “bu araba”. Makine her tahminde hata yaptıkça kendi içindeki sayıları biraz düzeltti. Bu düzeltmelerin nasıl yapıldığını matematik sezgisi dersinde topun yokuştan yuvarlanmasıyla göreceksin.
2009’da araştırmacılar bu iş için ImageNet adında, milyonlarca etiketli fotoğraftan oluşan dev bir veri kümesi hazırladı. 2012’de bu veriyle eğitilen bir ağ, önceki bütün yöntemleri açık farkla geçti. Bu hikâyenin devamı Tarih sayfasında.
6. Kendi fotoğrafını göster
Şimdi gerçek bir modeli deneme sırası sende. Aşağıdaki model ImageNet’in 1000 sınıfıyla eğitilmiş küçük bir görüntü modeli. Kedi, köpek, fincan, bisiklet, muz gibi gündelik nesneleri tanıyabilir.
Bir fotoğraf seç. Model önce onu 224 × 224 piksele küçültür. Sağda, aynı fotoğrafı büyük karelere bölünmüş hâliyle görüyorsun: Makinenin elinde olan şey bu karelerin sayılarıdır. Sonra model tahmin ettiği beş sınıfı ve her birine ne kadar güvendiğini gösterir.
Model senin tarayıcında çalışıyor; fotoğrafın hiçbir yere gönderilmiyor. İlk denemede model ve onu çalıştıran program internetten iner (toplam yaklaşık 10 MB), bu biraz sürebilir. Sonraki denemeler hızlıdır.
Bir de modelin tanımadığı bir şey dene: bir el yazısı, bir manzara ya da bir insan yüzü. Model yine beş tahmin verir, çünkü elinde sadece o 1000 sınıf var. “Bilmiyorum” diyemez. Bunu Yapay zekâ neden bazen uydurur? sayfasında konuşuyoruz.
Akılda kalsın: Makine için bir fotoğraf, sayılardan oluşan bir tablodur. Görmek, bu sayılarda tekrar eden örüntüleri bulmak ve onları katman katman anlamlı şeylere dönüştürmektir.
Kaynaklar
- Stanford CS231n ders notları: Image Classification ↗Bir resmin makine için sayı tablosu olması
- LeCun ve diğerleri (1998): Gradient-Based Learning Applied to Document Recognition ↗Resmin üzerinde kayan filtreler (evrişimli ağ)
- Deng ve diğerleri (2009): ImageNet: A large-scale hierarchical image database ↗Milyonlarca etiketli fotoğraf
- Krizhevsky, Sutskever ve Hinton (2012): ImageNet Classification with Deep Convolutional Neural Networks ↗2012’deki büyük sıçrama
- Mark I Perceptron kullanım kılavuzu, 2. şekil (1960) ↗400 ışık algılayıcılı göz
- Fotoğraf: Mark I Perceptron, ABD Donanma Müzesi ↗Kamu malı, Wikimedia Commons; iki renkli baskı bu sitede uygulandı
- Mehta ve Rastegari (2021): MobileViT ↗Sayfadaki deneyde çalışan model